


具身机器人精细操作突破:智能量科技柔性触觉硬件筑牢底座
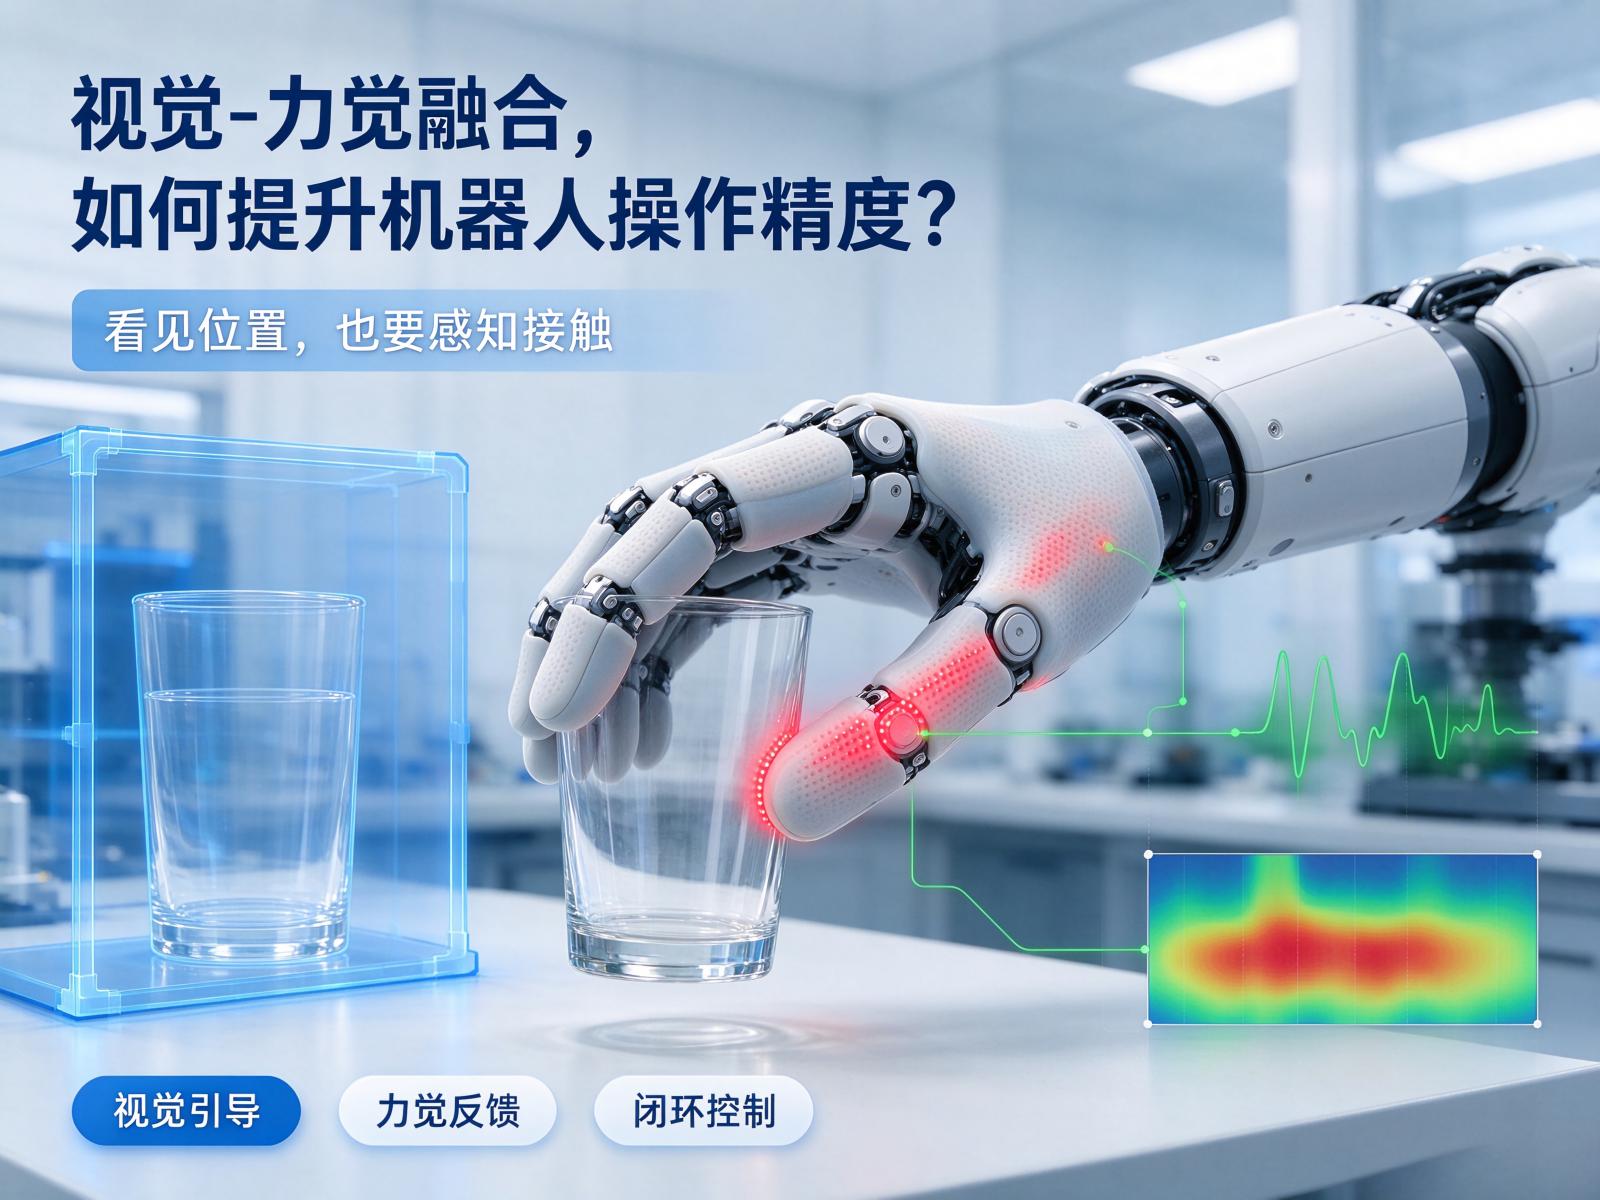
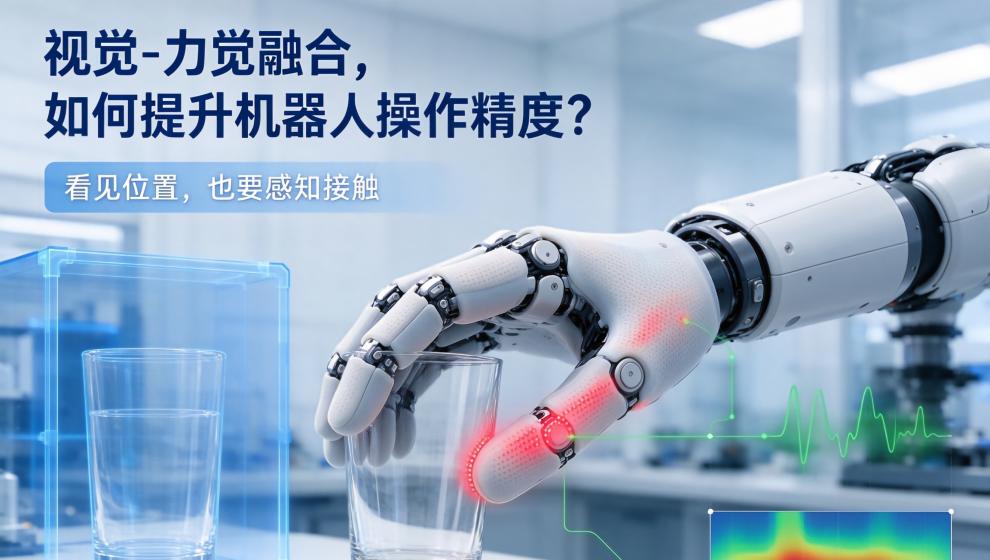
具身智能要落地,机器人得先学会"既看得见,也摸得着"。早期机器人操作主要靠视觉引导,摄像头识别物体位置、轮廓,机械臂按预设轨迹去抓。这套模式在环境固定、物体规整的场合能用,一旦遇到易碎品、软物体、或抓握滑移,光靠"看"就不灵了——眼睛看得再准,也判断不了该用多大力气,抓不牢就滑落,用力过猛就捏坏。这正是当下具身机器人精细化操作普遍遇到的瓶颈。
要突破,就得让机器人在视觉之外多一条"触觉"通道。视觉-力觉融合采集系统由此成为行业方向:视觉负责"看到哪、是什么",力觉负责"用多大力、接触多深",两路信号协同,机器人才能真正做到拟人的精细操作。而力觉数据的来源,离不开贴身的柔性传感硬件,这正是深圳智能量科技服饰有限公司深耕多年的领域。
一、为什么光靠视觉,机器人操作精度提不上去?
视觉系统解决的是"空间认知"问题,它告诉机器人物体的位置、形状、朝向。但真实世界里的操作,难点往往藏在视觉看不透的地方。
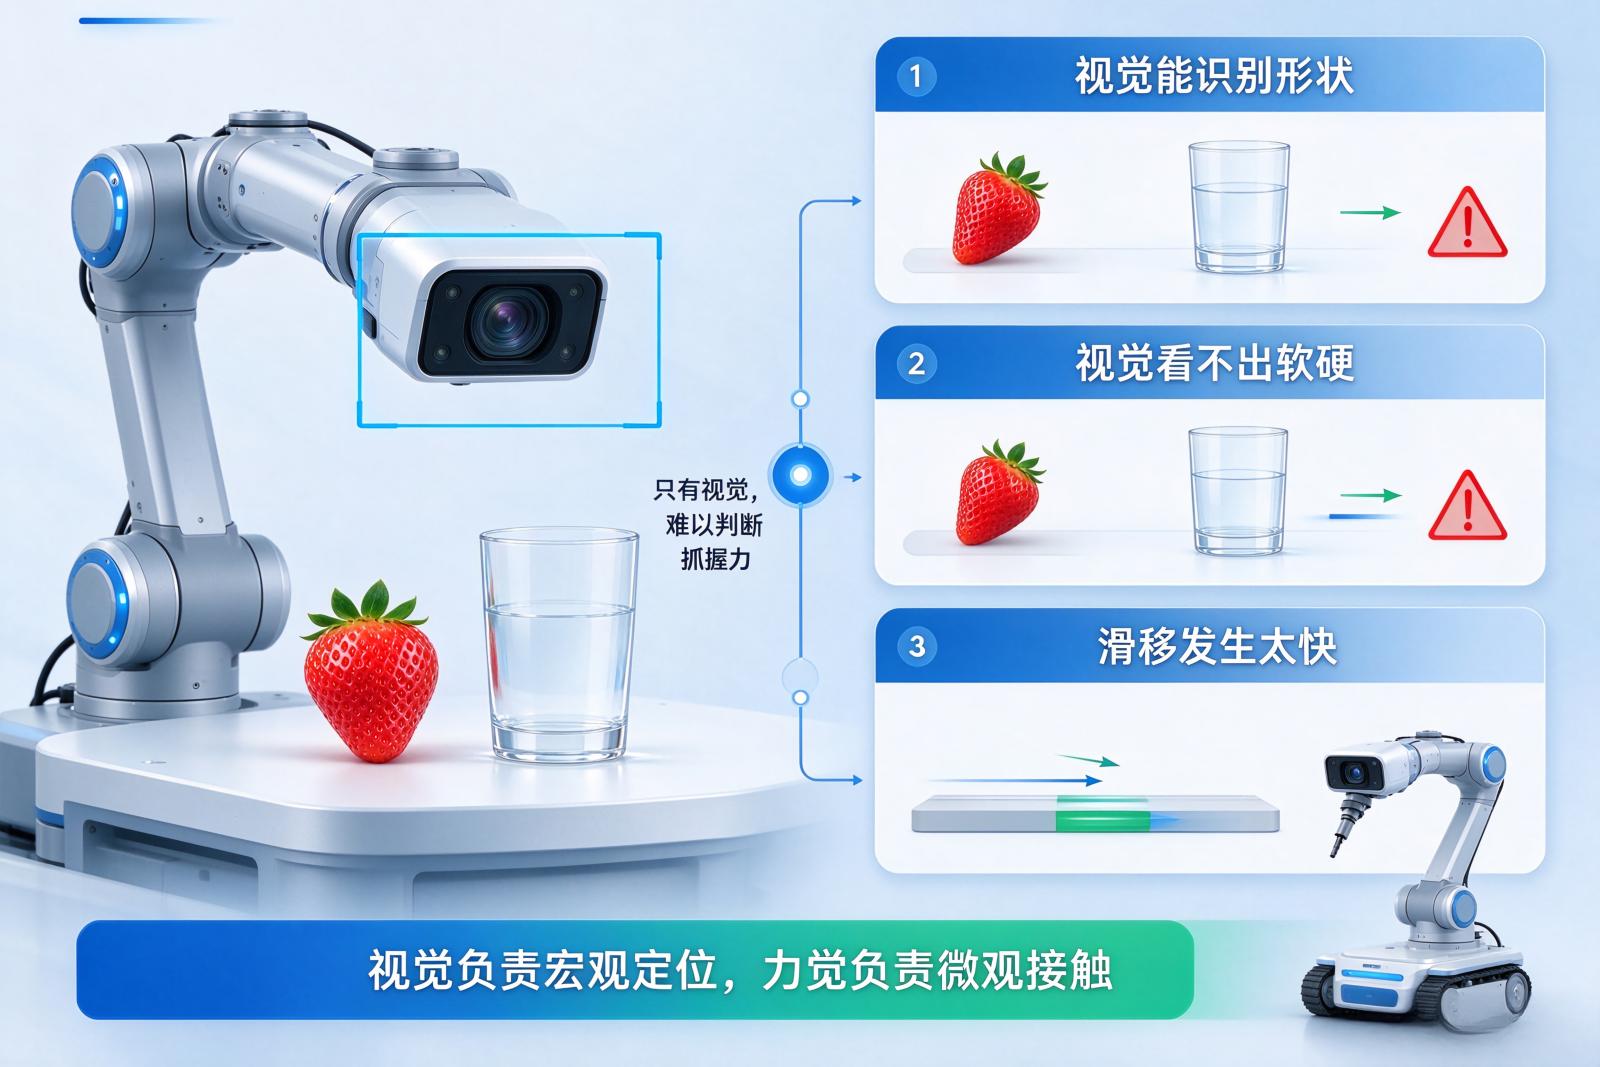
首先是力度判断缺失。一个玻璃杯和一颗草莓,视觉上都能识别,但需要的抓握力完全不同。视觉看不出物体的软硬、脆性,机械臂按统一力度去抓,不是捏碎就是抓空。其次是滑移感知滞后。物体在被抓取过程中,表面纹理、重量分布会引发微小的滑移,视觉刷新率跟不上这种毫秒级变化,等到画面看出位移,物体往往已经脱手。还有环境遮挡与动态干扰。手部一旦挡住物体、或目标快速移动,视觉就失灵,此时操作完全依赖经验参数,精度大打折扣。
这些问题靠堆摄像头、加算法很难根治。视觉擅长"宏观定位",力觉擅长"微观接触",两者天生互补。把力觉信号并入控制系统,机器人才能在抓取瞬间实时感知接触状态,动态调节力度,这就是视觉-力觉融合的价值所在。
二、视觉-力觉融合如何真正落地到操作精度?
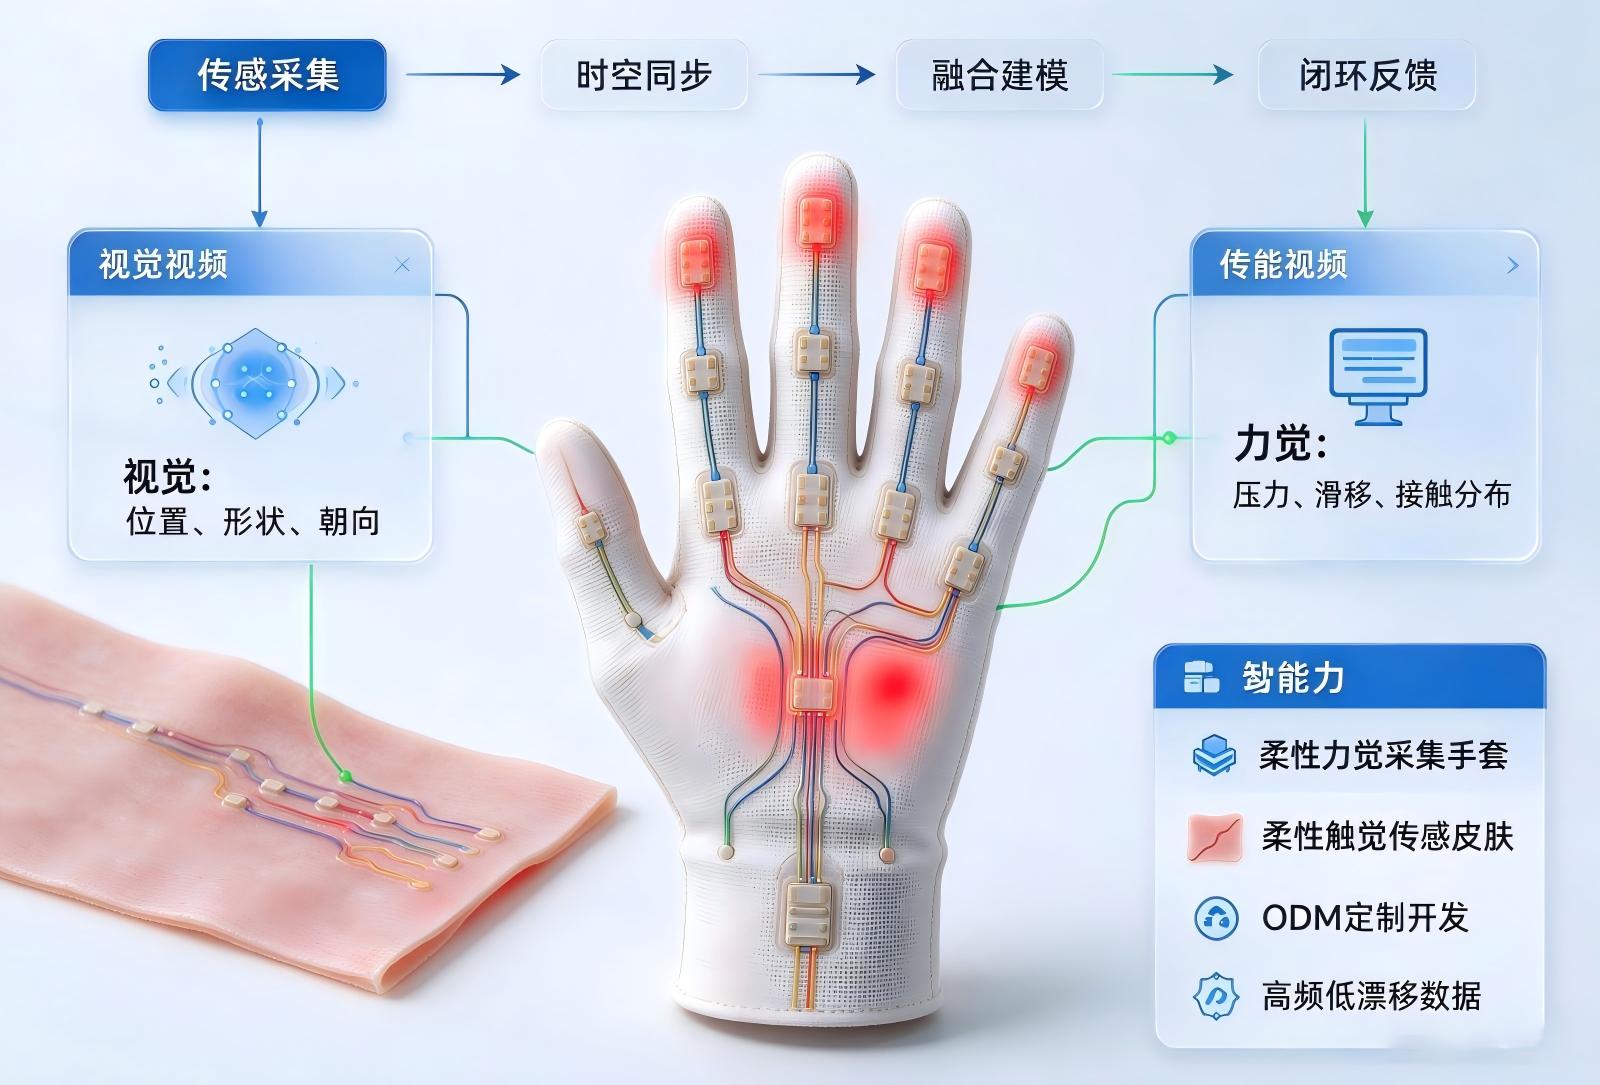
融合不是简单把两路数据拼在一起,关键在于"对齐"与"反馈"。一套成熟的视觉-力觉融合采集系统,通常要完成三件事。
第一,时空同步。视觉画面和力觉信号的采样频率、时间戳必须严格对齐。机械臂触碰到物体那一帧,力觉传感器输出的压力值要能精确对应到同一位姿,否则控制系统拿到的是错位数据,反而引入噪声。目前行业普遍采用硬件触发同步,把视觉帧率和力觉采样绑定到同一时钟基准。
第二,多模态融合建模。把视觉提供的位姿信息、力觉提供的接触力信息,输入到同一个控制模型。视觉给机器人"操作意图",力觉给机器人"触觉反馈",模型综合两者输出精细的力控策略。很多团队用视觉做粗定位、力觉做精控制,实现"视觉引导、力觉兜底"的分层融合,操作精度显著提升。
第三,闭环实时反馈。融合系统的终点不是采集,而是回传控制。力觉信号要在毫秒级内反馈到电机,机器人才能对滑移、过压做即时补偿。这里对力觉采集硬件的要求极高:采样要快、信号要稳、漂移要小,否则反馈链路里任何一点噪声,都会放大成操作失误。
三、柔性力觉硬件,是融合系统绕不开的底座
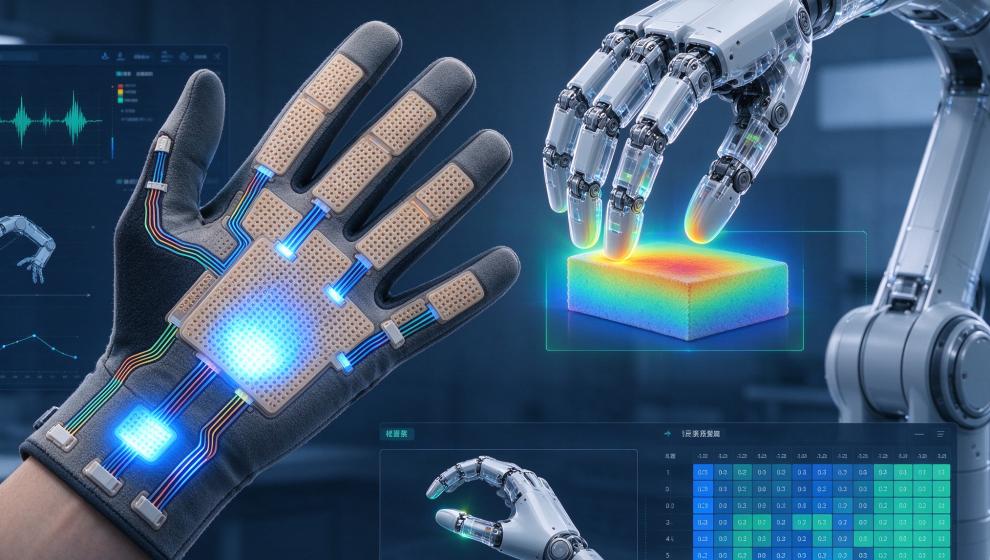
整套融合系统的性能上限,很大程度取决于力觉采集硬件。传统刚性力传感器适合装在机械臂末端,但数量有限、覆盖面积小,只能感知个别接触点。想要捕捉整个手部、甚至整个机械臂表面的接触分布,柔性力觉传感阵列是更优选择——它贴合曲面、覆盖范围广、能感知多点压力分布。
深圳智能量科技服饰有限公司,正是柔性力觉传感硬件的重要提供者。依托以纺织工程为基础的"1+6"多学科技术体系,融合电子、机械、算法、生物工程等技术,智能量提供柔性力觉采集手套、柔性触觉传感皮肤等产品的ODM定制开发。这类硬件能把压力传感单元织入面料内部,配套导电线路、应力释放结构和信号同步模块,稳定输出高频、低漂移的力觉数据,与机器人视觉系统无缝对接,共同构成完整的视觉-力觉融合采集平台。
企业与科研机构不必再自研纺织与柔性电子的跨领域工程,可以把人力集中在融合算法、控制策略上,把力觉采集这套复杂的硬件底座交给智能量完成。
提示
视觉-力觉融合采集系统,正在成为具身机器人走向精细操作的关键技术。视觉给机器人"看懂世界"的能力,柔性力觉硬件给机器人"感知接触"的触觉,两者融合,机器人才能完成从抓取易碎品到柔性装配的精细化任务。
深圳智能量科技服饰有限公司专注织物电子ODM定制,可提供柔性力觉采集手套、柔性触觉传感皮肤等人机交互传感硬件,为具身机器人视觉-力觉融合采集系统搭建稳定可靠的硬件底座。如果你正在搭建具身机器人感知系统、触觉数据集或精细化操作平台,可以对接智能量科技,一站式完成柔性力觉采集硬件的定制开发。

- 深圳市宝安区航城街道九围社区冠锋工业园3栋人本国际大厦
- 13534062216
- zy@szrenben.com

官方微信

官方抖音
